تنظيف بيانات البحث في برنامج الجداول الإلكترونية قبل التحليل
تنظيف بيانات البحث قبل التحليل عبر معالجة القيم المفقودة والتكرار والأخطاء والقيم الشاذة وتنظيم الجداول وتجهيز قاعدة بيانات دقيقة للتحليل الإحصائي.
تنظيف بيانات البحث في برنامج الجداول الإلكترونية قبل التحليل
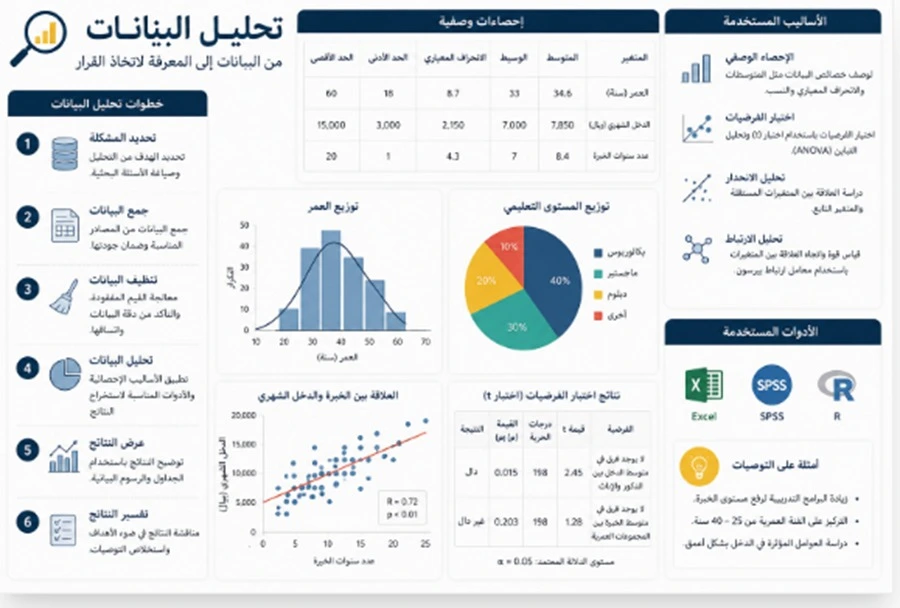
يبدأ تنظيف بيانات البحث في برنامج الجداول الإلكترونية قبل التحليل قبل تنفيذ أي اختبار إحصائي؛ لأن دقة المتوسطات والعلاقات والفروق والانحدار تعتمد أولًا على جودة البيانات الموجودة داخل الملف. خلية فارغة قد تعني إجابة مفقودة أو سؤالًا غير مطبق على المشارك، وصف مكرر قد يكون نسخة بالخطأ أو مشاركة حقيقية ثانية، وقيمة بعيدة عن بقية القيم قد تكون خطأ إدخال أو حالة صحيحة لا يجوز حذفها تلقائيًا. لذلك التنظيف الجيد لا يعني تعديل البيانات حتى تبدو مرتبة، بل يعني اكتشاف الأخطاء والتناقضات وتوثيق القرارات والمحافظة على النسخة الخام ثم إنشاء نسخة عمل منظمة وقابلة للتتبع. وبعدها فقط يصبح ملف البحث جاهزًا للانتقال إلى البرنامج الإحصائي والتحليل بثقة أكبر.
تنظيف بيانات البحث
يعني تنظيف بيانات البحث فحص الملف بصورة منهجية لاكتشاف المشكلات اللي ممكن تؤثر على التحليل أو تجعل الباحث يفسر بيانات مختلفة عن اللي تم جمعها فعلًا.
أول قاعدة مهمة هي عدم البدء بالتعديل على النسخة الأصلية.
يُفضل الاحتفاظ بملف خام كما تم تصديره من الاستبانة الإلكترونية أو إدخاله من النماذج الورقية، ثم إنشاء نسخة منفصلة للتنظيف.
هذا الفصل مهم جدًا.
لو اكتشف الباحث بعد أيام إن قيمة تم تعديلها بصورة خاطئة، يقدر يرجع إلى الأصل ويعرف وش كانت الاستجابة الحقيقية.
أما إذا تم تعديل الملف الخام نفسه بدون نسخة احتياطية، قد يصبح من الصعب التمييز بين البيانات الأصلية والتعديلات اللاحقة.
بعد ذلك يبدأ الفحص العام.
كم عدد الصفوف؟
هل كل صف يمثل مشاركًا واحدًا؟
هل عدد الحالات يطابق تقريبًا عدد الاستجابات المتوقع؟
هل جميع الأعمدة موجودة؟
هل أسماء المتغيرات مفهومة؟
هل توجد خلايا مدمجة؟
هل هناك أعمدة فارغة أو أعمدة تقنية ما لها علاقة بالتحليل؟
ثم يتم إجراء مراجعة للقيم.
لو متغير العمر يفترض أن يحتوي أعمارًا منطقية ضمن مجتمع الدراسة وظهرت قيمة 222، فهذي تحتاج فحصًا.
ولو مقياس الاستجابة من 1 إلى 5 وظهرت قيمة 8، فهناك غالبًا خطأ في الإدخال أو الترميز.
لكن الباحث ما يعدل القيمة بالتخمين.
يرجع إلى المصدر الأصلي أو نموذج الاستجابة إذا كان متاحًا.
-
يتم الاحتفاظ بالنسخة الخام بدون تعديل وإنشاء نسخة مستقلة للتنظيف.
-
كل تعديل مهم يفضل تسجيل سببه بدل تغيير القيم بصمت.
-
نطاقات القيم والتكرارات من أبسط الفحوص اللي تكشف أخطاء الإدخال مبكرًا.
معالجة القيم المفقودة
تعتبر معالجة القيم المفقودة من أكثر مراحل التنظيف اللي تحتاج حذرًا؛ لأن الخلية الفارغة ما تحمل دائمًا المعنى نفسه.
ممكن المشارك ترك سؤالًا بدون إجابة.
وممكن السؤال لم يظهر له أصلًا بسبب شرط انتقال في الاستبانة.
وممكن تكون القيمة فقدت أثناء نقل البيانات.
وممكن تكون الإجابة موجودة في النسخة الأصلية لكن ما تم إدخالها يدويًا.
هذي الحالات مختلفة.
قبل التفكير في التعويض أو الحذف، لازم أولًا نعرف مقدار القيم المفقودة ومكانها.
هل النقص موزع على عدة أسئلة؟
ولا يوجد متغير واحد فيه نسبة مرتفعة من القيم المفقودة؟
هل مجموعة معينة من المشاركين تركت سؤالًا بعينه؟
هل المفقود مرتبط بطريقة عرض السؤال؟
يمكن استخدام الفلاتر داخل برنامج الجداول لإظهار الخلايا الفارغة ومراجعتها.
كذلك يمكن استخدام صيغ عدّ بسيطة لمعرفة عدد القيم الموجودة والمفقودة في كل عمود.
ومن الأخطاء الشائعة استبدال كل قيمة مفقودة بمتوسط العمود بصورة تلقائية.
هذا القرار قد يغيّر التوزيع ويقلل التباين ويؤثر على العلاقات بين المتغيرات.
طريقة التعامل مع المفقود تعتمد على سبب الفقد ونسبته ونوع المتغير والتحليل اللي سيتم تنفيذه لاحقًا.
كذلك استخدام الصفر كرمز للمفقود يحتاج حذرًا إذا الصفر قيمة حقيقية ممكنة.
الأفضل يكون المفقود مميزًا بوضوح ولا يدخل في العمليات الحسابية وكأنه استجابة فعلية.
-
الفراغ لا يعني دائمًا نفس الشيء لذلك يتم تحديد سبب القيمة المفقودة قدر الإمكان.
-
ما يتم تعويض القيم المفقودة بمتوسط أو رقم ثابت تلقائيًا بدون مبرر إحصائي.
-
لازم يكون رمز المفقود مختلفًا بوضوح عن أي قيمة حقيقية ممكنة في المتغير.
تصحيح أخطاء البيانات
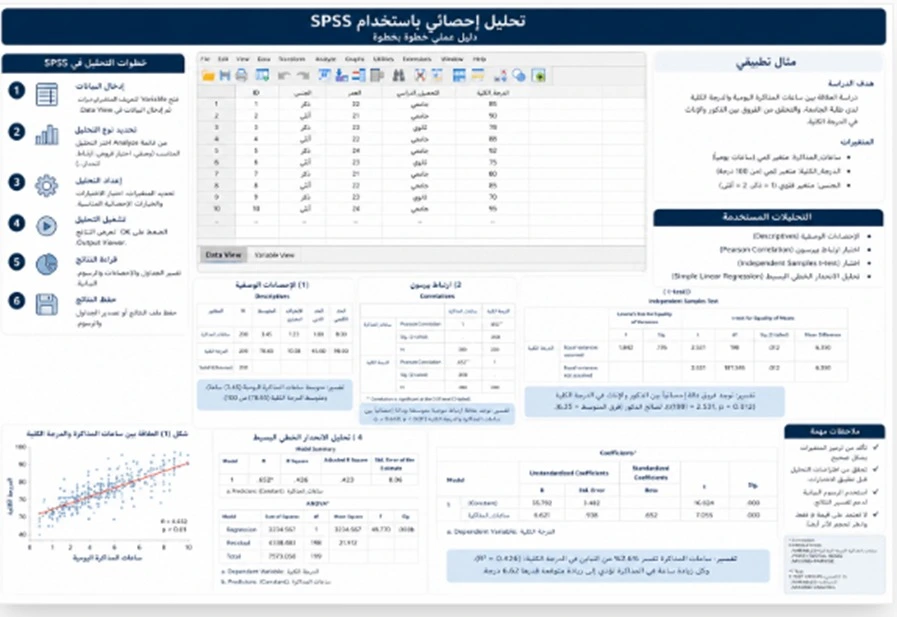
يشمل تصحيح أخطاء البيانات اكتشاف القيم اللي دخلت أو انتقلت بصورة مختلفة عن الاستجابة الأصلية.
الأخطاء ممكن تكون بسيطة جدًا.
مثل كتابة 55 بدل 5.
أو كتابة 21 بدل 12.
أو ظهور "ذكر " بمسافة في النهاية كفئة مختلفة عن "ذكر".
وممكن تكون أكثر تعقيدًا.
مثل وجود تاريخ مكتوب يوم/شهر/سنة في بعض الصفوف وشهر/يوم/سنة في صفوف ثانية.
أو رقم محفوظ كنص في بعض الخلايا ورقم فعلي في خلايا أخرى.
برنامج الجداول ممكن يعرض القيم بشكل متشابه رغم إنها مخزنة بصيغ مختلفة، وهذي المشكلة تظهر لاحقًا عند الفرز أو الحساب.
ولهذا يتم توحيد أنواع البيانات.
الأرقام تصبح رقمية.
التواريخ تأخذ تنسيقًا ثابتًا.
الفئات النصية تُراجع من ناحية المسافات والتهجئة والاختلافات غير المقصودة.
لكن التصحيح لازم يعتمد على دليل.
إذا كانت القيمة 71 للعمر في عينة معظمها طلاب عمرهم بين 18 و25، ما نحولها تلقائيًا إلى 17 لأننا "نتوقع" إن الباحث قلب الرقمين.
لازم نرجع للمصدر إذا كان موجودًا.
إذا تعذر التأكد، يتم توثيق المشكلة والتعامل معها حسب خطة البحث بدل اختراع قيمة.
-
الخطأ الواضح يتم تصحيحه بالرجوع للمصدر الأصلي كلما أمكن.
-
القيم النصية المتشابهة يتم توحيدها إذا كانت تمثل الفئة نفسها فعلًا.
-
القيمة غير المعتادة ما تتحول إلى رقم "منطقي" بمجرد التخمين.
تجهيز الجداول للتحليل الإحصائي
يعتمد تجهيز الجداول للتحليل الإحصائي على تحويل الملف إلى بنية سهلة القراءة والاستيراد من برامج التحليل.
في الشكل الشائع لبيانات الاستبيان، يمثل كل صف مشاركًا أو حالة واحدة، ويمثل كل عمود متغيرًا واحدًا.
هذا التنظيم يسهل مراجعة البيانات ونقلها إلى البرامج الإحصائية.
يفضل تجنب:
-
الخلايا المدمجة داخل منطقة البيانات.
-
وجود عنوانين فوق العمود نفسه.
-
صفوف فارغة بين المشاركين.
-
كتابة الملاحظات داخل خلايا المتغيرات.
-
جمع أكثر من متغير مختلف داخل العمود نفسه.
-
وضع أكثر من قيمة في الخلية بدون طريقة واضحة للترميز.
مثلًا إذا عند الباحث العمر والتخصص والجنس و20 بندًا للاستبيان، يكون لكل عنصر عمود مستقل.
أما الملاحظات الإدارية فتُحفظ في ورقة أخرى أو عمود واضح ما يدخل في التحليل.
كذلك يفضل أن تكون أسماء الأعمدة مختصرة ومنظمة وفريدة.
اسم مثل Q1 ممكن يكون مقبولًا إذا عند الباحث قاموس يوضح معنى السؤال.
أما وجود ثلاثة أعمدة كلها باسم "الدرجة" فيخلق مشكلة عند الاستيراد والمراجعة.
ويتم التأكد إن الصف الأول للعناوين فقط، وبعده تبدأ البيانات.
تنظيم الجدول بهذه الطريقة يتفق مع الممارسة العامة لتحضير ملفات التحليل، حيث يوصي NIST بجمع البيانات في ملف واحد منظم تكون فيه المتغيرات في الأعمدة والقيم في الصفوف، ثم تنفيذ فحص جودة لاكتشاف مشاكل الإدخال والقيم غير المعتادة والمفقودات.
-
كل عمود يمثل متغيرًا محددًا وكل صف يمثل حالة واحدة في معظم قواعد بيانات الاستبيان.
-
يتم إزالة العناصر التنسيقية اللي تعطل الاستيراد مثل الخلايا المدمجة والصفوف الزائدة.
-
أسماء المتغيرات تكون فريدة ومفهومة ومربوطة بقاموس بيانات.
إزالة التكرار من بيانات البحث
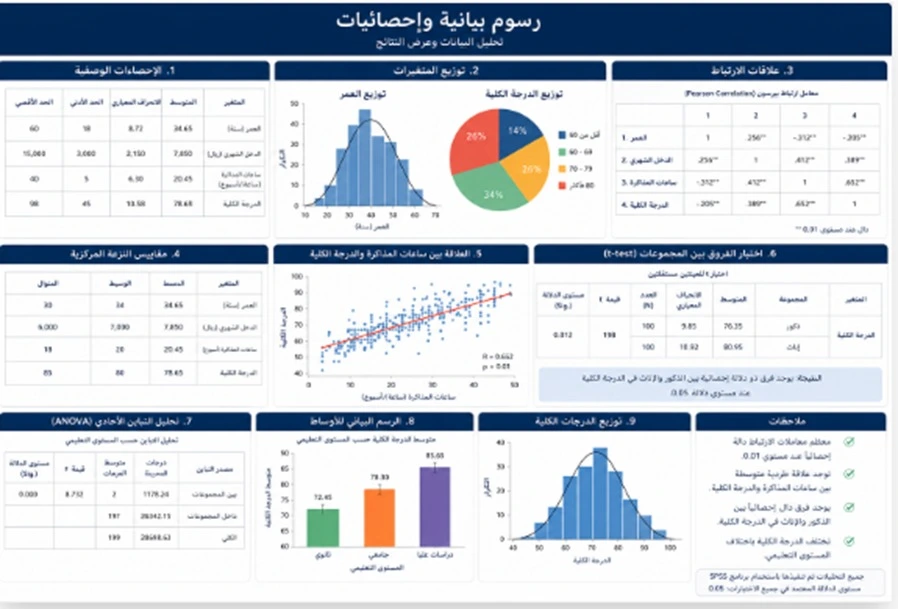
تحتاج إزالة التكرار من بيانات البحث إلى أكثر من الضغط على أمر "إزالة التكرارات".
الصفان المتطابقان قد يمثلان تكرارًا فعليًا.
لكن ممكن أيضًا شخصان مختلفان أعطيا الإجابات نفسها.
خصوصًا في الاستبيانات القصيرة.
لهذا لازم نعرف وش المتغيرات اللي تسمح لنا بالحكم على التكرار.
إذا يوجد معرف استجابة فريد، يمكن استخدامه للمراجعة.
وإذا النموذج يسجل وقت الإرسال، قد يساعد التوقيت مع معلومات أخرى في اكتشاف الاستجابة المكررة.
أما الاعتماد على تشابه الإجابات فقط فقد يؤدي إلى حذف حالة صحيحة.
وإذا ظهر نفس المعرف مرتين، لازم نفهم السبب.
هل المشارك أرسل النموذج مرتين؟
هل كانت هناك محاولة أولى غير مكتملة ثم ثانية كاملة؟
هل سياسة الدراسة تسمح بآخر استجابة فقط؟
هذي قرارات منهجية لازم تكون واضحة.
وفي البيانات المدخلة يدويًا، قد يحدث التكرار لأن الشخص نفسه تم إدخال نموذجه مرتين.
يمكن مقارنة رقم الاستبانة أو المعرف الداخلي بالمصدر الورقي.
ومن المفيد إضافة عمود مؤقت لكشف التكرارات أو استخدام التنسيق الشرطي والفلاتر، لكن الحذف النهائي ما يتم إلا بعد التأكد.
-
الصف المتشابه مو دليلًا كافيًا وحده على إن الحالة مكررة.
-
المعرفات الفريدة وتوقيت الإرسال والمصدر الأصلي تساعد في التحقق من التكرارات.
-
سبب حذف أي استجابة مكررة يفضل تسجيله حتى يظل عدد الحالات النهائي قابلًا للتفسير.
مراجعة القيم الشاذة
تعني مراجعة القيم الشاذة اكتشاف القيم اللي تبدو بعيدة بصورة واضحة عن بقية البيانات، ثم تحديد هل هي خطأ أم ملاحظة حقيقية.
مثلًا إذا معظم درجات متغير معين تقع بين 40 و80 وظهرت قيمة 400، فهذي تستحق الفحص.
لكن كلمة "شاذة" ما تعني تلقائيًا "خاطئة".
NIST يوضح إن القيمة البعيدة ممكن تكون ناتجة عن خطأ ترميز أو جمع، وممكن تكون ملاحظة صحيحة أو تحمل معلومات مهمة، ولذلك لا يوصى بالحذف التلقائي بدون فحص السبب.
داخل برنامج الجداول يمكن البدء بأدوات بسيطة:
-
الفرز من الأصغر للأكبر.
-
حساب الحد الأدنى والأقصى.
-
مراجعة الربيعات.
-
إنشاء رسم صندوقي إذا كان البرنامج يدعمه.
-
رسم البيانات.
-
مقارنة القيمة بالمصدر الأصلي.
وفي بعض الحالات تُستخدم قواعد إحصائية لاكتشاف القيم المحتملة مثل نطاق الربيعات أو درجات معيارية، لكن ظهور القيمة ضمن معيار "محتمل أن تكون شاذة" ما يعني حذفها مباشرة.
لو كانت نتيجة خطأ إدخال، تُصحح.
لو كانت صحيحة وممكنة، يتم الاحتفاظ بها غالبًا أو تقييم أثرها واختيار أسلوب تحليل مناسب حسب الدراسة.
وإذا قرر الباحث استبعادها، لازم يكون عنده معيار مبرر ومعلن.
-
القيم الشاذة يتم تحديدها ثم التحقيق فيها بدل حذفها آليًا.
-
الرسم والفرز والحد الأدنى والأقصى أدوات مفيدة للفحص الأولي.
-
قرار الاحتفاظ أو الاستبعاد يعتمد على سبب القيمة وتصميم الدراسة، مو على رغبة الباحث في تحسين النتيجة.
تنظيم بيانات الاستبيان في الجداول
يحتاج تنظيم بيانات الاستبيان في الجداول إلى تحويل الاستجابات إلى قاعدة يسهل تدقيقها قبل أي تحليل.
يبدأ ذلك بتثبيت هوية كل عمود.
مثلًا:
-
ID
-
العمر
-
الجنس
-
التخصص
-
Q1
-
Q2
-
Q3
-
محور1_درجة
-
محور2_درجة
إذا كان الاستبيان يحتوي أسئلة متعددة الاختيارات، لازم تكون طريقة التخزين واضحة.
سؤال "اختر كل الخيارات اللي تنطبق عليك" قد يحتاج أكثر من عمود، بحيث يكون لكل خيار متغير يوضح هل تم اختياره أو لا.
أما كتابة "واتساب، إيميل، منصة" في خلية واحدة قد تكون مناسبة للحفظ النصي لكنها تحتاج تجهيزًا إضافيًا قبل التحليل.
كذلك الأسئلة المفتوحة تظل في أعمدة نصية مستقلة.
ولو سيتم تصنيفها لاحقًا، الأفضل الاحتفاظ بالنص الأصلي وعدم استبداله بالفئة المرمزة فقط.
ومن المهم عند تنظيم بيانات الاستبيان في الجداول عدم استخدام الألوان وحدها لنقل معنى البيانات.
مثلًا ما ينفع يكون الصف الأحمر "مستبعد" والأخضر "مقبول" بدون عمود يوضح حالة الاستجابة؛ لأن اللون قد لا ينتقل للبرنامج الإحصائي.
الأفضل وجود متغير مثل "حالة_الحالة" أو سجل منفصل لقرارات الاستبعاد.
كذلك يتم تثبيت طريقة كتابة الفئات.
إذا التخصص "إدارة أعمال"، ما يكون مرة "إدارة أعمال" ومرة "ادارة" ومرة "Business".
إلا إذا كانت هذي فئات مختلفة فعلًا.
-
معنى البيانات يُسجل داخل القيم والمتغيرات وليس بالألوان فقط.
-
الأسئلة متعددة الاختيارات تحتاج بنية تسمح بتحليل كل اختيار بوضوح.
-
النص الأصلي للأسئلة المفتوحة يُحفظ حتى بعد إنشاء ترميز أو تصنيف تحليلي له.
تنسيق قاعدة بيانات الدراسة
يختلف تنسيق قاعدة بيانات الدراسة عن التنسيق الجمالي لملف العرض.
الهدف مو اختيار ألوان وخطوط جميلة.
الهدف إنشاء ملف مستقر ومفهوم ويمكن نقله إلى برنامج التحليل بدون فقد المعنى.
من المفيد تقسيم الملف إلى أوراق وظيفية عند الحاجة، مثل:
ورقة Raw:
للنسخة الخام من البيانات.
ورقة Clean:
للبيانات بعد التنظيف.
ورقة Dictionary:
لقاموس المتغيرات.
ورقة Log:
لسجل التعديلات والقرارات.
ورقة Checks:
للفحوص المؤقتة والصيغ المستخدمة للتدقيق.
هذا التقسيم يساعد على منع الخلط بين البيانات الأصلية والصيغ والحسابات.
وفي ورقة البيانات النهائية يفضل تحويل الصيغ المهمة إلى قيم فقط إذا كان ذلك مطلوبًا عند التصدير، مع الاحتفاظ بنسخة تحتوي الصيغ الأصلية للمراجعة.
كذلك يتم الانتباه للفواصل العشرية والتواريخ عند نقل الملف بين برامج أو أجهزة بإعدادات إقليمية مختلفة.
وقد يظهر الرقم 1,5 بطريقة مختلفة حسب إعداد البرنامج.
ولهذا لازم يتم فحص الملف بعد التصدير وليس افتراض إن كل القيم انتقلت بصورة صحيحة.
كما يتم تقليل البيانات الشخصية غير الضرورية في نسخة التحليل.
إذا الاسم ورقم الهاتف ما لهم وظيفة إحصائية، الأفضل عدم وجودهم في ملف التحليل متى كان تصميم الدراسة ومتطلبات الجامعة والأخلاقيات تسمح بذلك.
-
تنسيق قاعدة البيانات هدفه الثبات وسهولة المراجعة وليس الشكل البصري فقط.
-
فصل Raw وClean وقاموس البيانات وسجل التغييرات يقلل أخطاء النسخ.
-
نسخة التحليل تحتوي فقط المعلومات اللازمة للبحث بقدر ما تسمح به خطة الدراسة ومتطلبات الخصوصية.
تدقيق البيانات قبل التحليل
تمثل تدقيق البيانات قبل التحليل المرحلة الأخيرة للتأكد إن المشكلة اللي تظهر لاحقًا في النتيجة مو أصلها خطأ داخل الملف.
التدقيق النهائي يتم على أكثر من مستوى.
فحص عدد الحالات
كم استجابة جُمعت؟
كم حالة موجودة في الملف الخام؟
كم حالة موجودة بعد التنظيف؟
إذا اختلف العدد، لازم يكون السبب معروفًا.
فحص نطاق القيم
كل متغير له نطاق متوقع.
مقياس 1 إلى 5 ما يحتوي 6 أو 15.
السؤال الثنائي ما يحتوي فئة ثالثة إلا لو كانت ضمن التصميم.
فحص الاتساق المنطقي
إذا شخص أجاب "لم أستخدم الخدمة"، هل من المنطقي إن عنده إجابات عن تفاصيل الاستخدام؟
إذا العمر أقل من الحد المطلوب للعينة، كيف دخلت الحالة؟
فحص المحاور
هل جميع البنود الصحيحة موجودة؟
هل البند العكسي تم التعامل معه بالطريقة المحددة؟
هل الدرجة المحسوبة تستخدم البنود المطلوبة فقط؟
فحص أنواع البيانات
هل العمر رقم؟
هل التاريخ تاريخ فعلًا؟
هل القيم المفقودة معرّفة بصورة مناسبة؟
فحص عينة يدوية
اختيار عدد من الصفوف ومقارنتها بالمصدر الأصلي يساعد على كشف أخطاء ما تظهر بالفلاتر.
وفي النهاية يتم حفظ نسخة نهائية تحمل اسمًا وتاريخًا واضحين بدل الاعتماد على أسماء مثل "آخر نسخة جدًا 3".
-
العدد النهائي للحالات لازم يمكن تتبعه من الملف الخام إلى ملف التحليل.
-
الفحص المنطقي بين الأعمدة مهم مثل فحص كل عمود على حدة.
-
يتم مراجعة نسخة التصدير النهائية بعد الحفظ وقبل إدخالها في البرنامج الإحصائي.
معالجة البيانات الخام للبحث
تشمل معالجة البيانات الخام للبحث كل القرارات اللي تحول الملف الأصلي إلى نسخة منظمة بدون تغيير الحقيقة اللي تم جمعها.
المعالجة ممكن تشمل:
-
إزالة أعمدة تقنية غير لازمة للتحليل.
-
تسمية المتغيرات.
-
توحيد الفئات.
-
تصحيح أخطاء إدخال مثبتة.
-
تمييز المفقودات.
-
كشف التكرار.
-
مراجعة القيم الشاذة.
-
إنشاء المتغيرات المشتقة.
-
حساب درجات المحاور عند الحاجة.
-
إنشاء سجل للاستبعادات.
-
تجهيز نسخة قابلة للاستيراد.
لكن المعالجة ما تشمل اختراع إجابة مكان المشارك.
ولا تغيير الاستجابة لأنها "مش منطقية" بالنسبة لتوقع الباحث.
ولا حذف حالات حتى تصبح الفرضية دالة.
ولا إعادة تصنيف الفئات بعد مشاهدة النتائج فقط لتحسين الجداول.
النسخة النظيفة لازم تظل تمثل البيانات اللي جُمعت بالفعل.
ولهذا من المفيد وجود سجل تنظيف يحتوي مثلًا:
وجود السجل يجعل التنظيف قابلًا للمراجعة بدل تحوله إلى سلسلة تعديلات ما يعرف أحد سببها.
وش الفرق بين تنظيف البيانات وترميزها؟
المرحلتان مرتبطتان لكنهما مختلفتان.
الترميز يحدد معنى القيم.
أما التنظيف فيسأل: هل القيم الموجودة فعلًا صحيحة ومتسقة وقابلة للاستخدام؟
قائمة فحص تنظيف البيانات في برنامج الجداول
قبل الانتقال للتحليل يمكن مراجعة القائمة التالية:
بنية الملف
-
كل صف يمثل حالة واحدة.
-
كل عمود يمثل متغيرًا واحدًا.
-
أسماء الأعمدة غير مكررة.
-
ما فيه خلايا مدمجة داخل البيانات.
-
الصفوف الفارغة غير الضرورية محذوفة.
-
الأعمدة غير المستخدمة محددة.
جودة القيم
-
نطاق كل متغير صحيح.
-
الفئات مكتوبة بطريقة موحدة.
-
الأرقام مخزنة كأرقام.
-
التواريخ بتنسيق ثابت.
-
ما توجد رموز غير معرفة.
-
البنود العكسية معروفة.
القيم المفقودة
-
عدد المفقودات في كل متغير معروف.
-
المفقود مختلف عن الصفر إذا الصفر قيمة ممكنة.
-
الأسئلة المتخطاة منطقيًا مميزة قدر الإمكان.
-
ما تم تعويض المفقود عشوائيًا.
التكرار
-
المعرفات الفريدة تمت مراجعتها.
-
التكرارات المحتملة تم فحصها.
-
ما تم حذف صف بناءً على التشابه فقط.
-
أسباب الحذف موثقة.
القيم غير المعتادة
-
تم فحص الحد الأدنى والأقصى.
-
تم استخدام الفرز أو الرسوم عند الحاجة.
-
القيم المحتملة كقيم شاذة تمت مراجعتها.
-
ما تم حذفها فقط لتحسين النتائج.
النسخة النهائية
-
الملف الخام محفوظ.
-
الملف المنظف محفوظ باسم مختلف.
-
قاموس البيانات محدث.
-
سجل التنظيف موجود عند الحاجة.
-
نسخة التصدير تم فتحها وفحصها.
-
عدد الحالات النهائي معروف.
استخدام الفلاتر والتحقق من صحة البيانات في التنظيف
الفلاتر من أكثر الأدوات البسيطة فائدة.
يمكن من خلالها إظهار:
-
الخلايا الفارغة.
-
قيمة معينة.
-
الفئات المختلفة.
-
أعلى وأقل الأرقام.
-
الحالات اللي تحمل حالة استبعاد معينة.
أما التحقق من صحة البيانات فيفيد خصوصًا أثناء الإدخال أو قبل استمرار العمل.
إذا السؤال يسمح بالقيم من 1 إلى 5، يمكن إعداد الخلية بحيث تقل احتمالية إدخال رقم خارج هذا النطاق.
لكن التحقق من صحة البيانات ما يغني عن التدقيق النهائي.
المستخدم ممكن يلصق بيانات بطريقة تتجاوز بعض القيود أو يكون الخطأ موجودًا أصلًا في مصدر البيانات.
التنسيق الشرطي كذلك مفيد لتحديد:
-
التكرارات.
-
القيم الأعلى أو الأقل.
-
الخلايا الفارغة.
-
القيم اللي تحقق شرطًا معينًا.
لكن اللون هنا أداة للفحص فقط، وليس جزءًا من البيانات النهائية.
كيف نراجع القيم النصية غير المتسقة؟
من أكثر المشكلات شيوعًا وجود فئة واحدة مكتوبة بأكثر من شكل.
مثل:
-
الرياض
-
رياض
-
الرياض
-
RIYADH
إذا كانت كلها تمثل الفئة نفسها فعلًا، يتم توحيدها.
لكن قبل ذلك لازم نعرف هل الاختلاف مقصود.
يمكن استخدام:
-
الفرز.
-
قائمة القيم الفريدة.
-
الفلاتر.
-
إزالة المسافات الزائدة.
-
البحث والاستبدال بحذر.
لكن البحث والاستبدال الجماعي ممكن يسبب أخطاء إذا الكلمة جزء من قيمة أخرى.
لذلك تتم مراجعة النتيجة بعد التنفيذ.
هل نحذف الصفوف الناقصة بالكامل؟
مو كقاعدة عامة.
صف فيه قيمة مفقودة واحدة ما يعني إن كل بيانات المشارك غير قابلة للاستخدام.
القرار يعتمد على:
-
مقدار النقص.
-
المتغيرات المفقودة.
-
نوع التحليل.
-
قواعد الأداة.
-
خطة البحث.
-
سبب المفقود.
بعض التحليلات قد تستخدم البيانات المتاحة بطريقة معينة.
وفي حالات ثانية قد تتطلب مجموعة متغيرات كاملة.
لذلك حذف كل صف يحتوي خلية فارغة ممكن يخسر الباحث بيانات كثيرة بلا مبرر.
هل نحذف القيم الشاذة من برنامج الجداول؟
لا يتم الحذف تلقائيًا.
القيمة الشاذة تمر بثلاث أسئلة:
هل هي خطأ؟
إذا نعم وتم التأكد من القيمة الصحيحة، تُصحح.
هل هي صحيحة لكنها نادرة؟
غالبًا يتم الاحتفاظ بها أو تقييم أثرها.
هل تؤثر بشدة على التحليل؟
يتم فحص تأثيرها واستخدام طريقة مناسبة بدل الحذف فقط لأن النتيجة تغيرت.
NIST يشدد على أن القيم الشاذة قد تحمل معلومات عن عملية القياس أو جمع البيانات، وينصح بفهم سببها قبل استبعادها.
ليش نحتاج ملف Raw وملف Clean؟
الملف الخام يحمي تاريخ البيانات.
والملف المنظف يستخدم للعمل.
إذا كان عند الباحث الملف المنظف فقط، ما يقدر بسهولة يعرف هل قيمة معينة أصلية أو تم تعديلها.
أما وجود الاثنين فيسمح بالمقارنة.
أفضل ممارسة عملية هي:
Raw: لا يتغير.
Clean: تُنفذ فيه التعديلات الموثقة.
Analysis: نسخة جاهزة للاختبار وقد تحتوي متغيرات مشتقة.
وبكذا ما تختلط الاستجابة الأصلية بدرجة محور تم حسابها لاحقًا.
أخطاء شائعة أثناء تنظيف بيانات البحث
من الأخطاء اللي ممكن تؤثر على التحليل:
-
تعديل الملف الخام مباشرة.
-
حذف الصفوف الفارغة بدون معرفة سببها.
-
تعويض جميع المفقودات بالمتوسط.
-
حذف جميع القيم الشاذة.
-
اعتبار كل صفين متطابقين حالة واحدة.
-
توحيد فئتين مختلفتين بالخطأ.
-
استخدام الألوان كأنها بيانات.
-
ترك الأرقام مخزنة كنصوص.
-
وجود صيغ في بعض الصفوف وقيم ثابتة في صفوف أخرى.
-
اختلاف طريقة كتابة التاريخ.
-
إدخال ملاحظات داخل عمود رقمي.
-
وجود مسافات زائدة في أسماء الفئات.
-
استخدام أكثر من رمز للمفقود بدون توثيق.
-
فقد النسخة الأصلية بعد التنظيف.
-
حذف المشاركين لأن نتائجهم ما توافق توقع الباحث.
-
عدم تسجيل سبب الاستبعاد.
-
ترك بيانات تعريف شخصية غير لازمة في نسخة التحليل.
-
تصدير الملف بدون مراجعته بعد التحويل.
-
عدم مقارنة العدد النهائي بعدد الحالات الأصلية.
-
بدء التحليل قبل إنهاء فحص البيانات.
لماذا تختار ركن لتنظيف وتجهيز بيانات البحث؟
يعلن ركن للترجمة والخدمات التعليمية ضمن خدماته الحالية عن تحليل البيانات والإحصاء باستخدام Excel وSPSS، إلى جانب أعمال الإكسل والجداول وعرض النتائج، لذلك يمكن أن يبدأ نطاق العمل من تجهيز الملف نفسه قبل التحليل حسب حالة بيانات الباحث.
قد يكون ملف الباحث صادرًا مباشرة من استبانة إلكترونية ويحتاج فقط تنظيف الفئات والمفقودات.
وقد تكون البيانات مدخلة يدويًا وتحتاج مراجعة أكبر لاكتشاف أخطاء الإدخال.
وفي حالة ثانية تكون المشكلة في تكرار الحالات أو صيغ التواريخ أو المتغيرات المخزنة كنص.
وقد يكون الملف منظمًا ظاهريًا لكن فيه قيم خارج النطاق أو محاور محسوبة من أعمدة غير صحيحة.
لذلك التعامل مع الملف يبدأ من فهم الاستبانة وخطة البحث، مو من حذف الخلايا الفارغة فقط.
وما يتم ضمان "تحسين النتائج" بعد التنظيف؛ لأن وظيفة التنظيف هي زيادة دقة تمثيل البيانات، وليس جعل النتائج دالة إحصائيًا.
كما لا يتم تغيير استجابات المشاركين أو حذف حالات فقط لأنها تؤثر على المتوسط أو الفرضية.
خطوات تنظيف البيانات قبل التحليل الإحصائي
يمكن تنظيم الخدمة على مراحل:
-
استلام ملف البيانات والنسخة النهائية من الاستبانة أو أداة الدراسة.
-
حفظ نسخة خام منفصلة قبل أي تعديل.
-
مراجعة عدد الصفوف والأعمدة مقارنة بمصدر البيانات.
-
تحديد وظيفة كل عمود وإنشاء أو تحديث قاموس المتغيرات.
-
توحيد أسماء المتغيرات والفئات بدون تغيير المعنى.
-
فحص نوع البيانات رقمية أو نصية أو تاريخ.
-
مراجعة القيم المفقودة ومكانها ونمطها.
-
فحص نطاق القيم لكل متغير.
-
كشف التكرارات المحتملة والتحقق منها قبل الحذف.
-
مراجعة القيم غير المعتادة والشاذة بالفرز والرسوم والأساليب المناسبة.
-
مراجعة الاتساق المنطقي بين المتغيرات.
-
فحص البنود العكسية ودرجات المحاور إذا كانت موجودة.
-
إنشاء سجل للتعديلات والاستبعادات المهمة.
-
إزالة العناصر اللي تعطل الاستيراد مثل الخلايا المدمجة والصفوف غير الضرورية.
-
إنشاء نسخة Clean واضحة الاسم.
-
إنشاء نسخة Analysis عند الحاجة تحتوي المتغيرات المشتقة.
-
تدقيق عينة من الصفوف مقابل المصدر الأصلي.
-
فحص الملف بعد التصدير أو التحويل.
-
تأكيد العدد النهائي للحالات والمتغيرات.
-
تسليم ملف جاهز للانتقال إلى مرحلة التحليل مع وضوح القرارات الرئيسية اللي تمت أثناء التنظيف.
بهذي الطريقة يعرف الباحث وش تغير داخل الملف وليش تغير، بدل ما يستلم جدولًا "مرتبًا" ما يقدر يعرف تاريخ تعديله.
أسعار تنظيف بيانات البحث
ما فيه سعر ثابت لخدمة تنظيف بيانات البحث في برنامج الجداول الإلكترونية قبل التحليل لأن حجم العمل يعتمد على حالة الملف وتعقيده.
العوامل المؤثرة تشمل:
-
عدد المشاركين.
-
عدد المتغيرات.
-
عدد أوراق العمل.
-
هل البيانات إلكترونية أو مدخلة يدويًا.
-
مقدار القيم المفقودة.
-
عدد الفئات النصية.
-
وجود بيانات متكررة.
-
عدد القيم غير المعتادة.
-
الحاجة للرجوع إلى نماذج أصلية.
-
وجود أسئلة متعددة الاختيارات.
-
وجود أسئلة مفتوحة.
-
الحاجة لبناء قاموس بيانات.
-
وجود بنود عكسية.
-
الحاجة لحساب درجات محاور.
-
عدد قواعد الاتساق المنطقي المطلوب فحصها.
-
وجود أكثر من مصدر بيانات.
-
الحاجة لدمج الملفات.
-
الحاجة لنسخة جاهزة لـSPSS أو برنامج إحصائي آخر.
-
موعد التسليم.
ملف يحتوي 100 استجابة إلكترونية منظمة يختلف عن عدة ملفات جداول تم جمعها من مصادر مختلفة وتحتاج دمجًا وتوحيدًا ومراجعة.
لذلك الأفضل إرسال ملف البيانات والنسخة النهائية من الاستبانة وقواعد الترميز وأي ملاحظات من المشرف حتى يتم تحديد نطاق التنظيف قبل التسعير.
الأسئلة الشائعة
هل تنظيف البيانات يعني حذف القيم غير الطبيعية؟
لا. التنظيف يعني فحص القيمة ومعرفة سببها. إذا كانت خطأ مثبتًا يتم تصحيحها، أما إذا كانت ملاحظة حقيقية فلا تُحذف تلقائيًا لمجرد إنها بعيدة عن بقية القيم.
هل أقدر أعوض كل القيم المفقودة بالمتوسط؟
مو كقاعدة عامة. طريقة معالجة المفقودات تعتمد على سببها ونسبتها ونوع المتغير والتحليل المطلوب، والتعويض العشوائي بالمتوسط ممكن يغيّر خصائص البيانات.
هل الصفوف المتشابهة تعتبر تكرارًا؟
مو دائمًا. مشاركان مختلفان ممكن يعطون الإجابات نفسها. الأفضل الاعتماد على معرف فريد أو معلومات موثوقة أخرى قبل حذف أي حالة باعتبارها مكررة.
هل أحتاج تنظيف الملف إذا كان صادرًا مباشرة من نموذج إلكتروني؟
نعم، المراجعة تظل مهمة. التصدير الإلكتروني يقلل أخطاء الإدخال اليدوي لكنه ما يمنع المفقودات أو التكرارات أو الاختلافات النصية أو المشكلات المنطقية أو القيم اللي تحتاج مراجعة قبل التحليل.
وش أرسل عند طلب تنظيف بيانات البحث؟
أرسل ملف البيانات الحالي والنسخة النهائية من الاستبانة أو أداة الدراسة وتعريف المتغيرات وطريقة الترميز الحالية وطريقة حساب المحاور إن وجدت وأي ملاحظات من المشرف.
الخاتمة
نجاح تنظيف بيانات البحث في برنامج الجداول الإلكترونية قبل التحليل ما يُقاس بعدد الصفوف اللي تم حذفها ولا بمدى جمال شكل الجدول.
الهدف الحقيقي هو إنشاء ملف يمثل البيانات الأصلية بأكبر قدر ممكن من الدقة.
تبدأ العملية بالحفاظ على النسخة الخام.
ثم يتم فحص بنية الجدول.
وتُراجع القيم المفقودة.
وتُصحح أخطاء الإدخال المثبتة.
ويتم التحقق من التكرارات بدل حذفها تلقائيًا.
وتُراجع القيم الشاذة بدون اعتبارها أخطاء لمجرد إنها مختلفة.
وتُوحد الفئات والصيغ وأنواع البيانات.
ثم يتم تدقيق عدد الحالات والمتغيرات وإنشاء نسخة نظيفة موثقة وقابلة للتحليل.
كل دقيقة تُصرف في اكتشاف مشكلة داخل الملف قبل التحليل ممكن تمنع خطأ ينتقل لاحقًا إلى المتوسط أو الارتباط أو الانحدار أو اختبار الفرضيات.
لذلك البيانات النظيفة ما تعني بيانات "مثالية"، وإنما تعني بيانات مفهومة ومتسقة وموثقة وتعكس ما تم جمعه فعلًا.
إذا عندك ملف بيانات بحث أو استبيان داخل برنامج جداول إلكترونية ويحتاج مراجعة قبل التحليل الإحصائي جهّز ملف البيانات والنسخة النهائية من الأداة وطريقة الترميز وملاحظات المشرف إن وجدت، ثم تواصل مع ركن للترجمة والخدمات التعليمية لتحديد هل المطلوب تنظيف القيم والمفقودات والتكرارات فقط أو تجهيز قاعدة البيانات بالكامل قبل نقلها إلى مرحلة التحليل الإحصائي.
هل تحتاج إلى مساعدة؟
تواصل معنا مباشرة عبر واتساب وسنرد عليك بأسرع وقت.
مقالات أخرى
مدرس رياضيات عن بعد للمنهج السعودي حسب المرحلة الدراسية
مدرس رياضيات عن بعد للمنهج السعودي بحصص تناسب المرحلة ومستوى الطالب، من التأسيس وشرح الدروس إلى حل المسائل والمراجعة والاستعداد للاختبارات.
اقرأ المقال ← التحليل الإحصائيتفسير نتائج التحليل الإحصائي ومراجعة فصل النتائج للبحث العلمي
تفسير النتائج الإحصائية ومراجعة فصل النتائج عبر شرح الجداول والدلالة وربط النتائج بأسئلة الدراسة وتنظيم المخرجات وصياغتها أكاديميًا بدقة.
اقرأ المقال ← تحليل المشاريع البحثيةتصميم لوحة مؤشرات احترافية للمشاريع ببرنامج الجداول الإلكترونية
صميم لوحة مؤشرات للمشاريع تجمع أهم الأرقام والنتائج والرسوم والمرشحات في شاشة واضحة تساعد على متابعة الأداء وتحديث البيانات واتخاذ القرار.
اقرأ المقال ←