ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي
ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي مع تعريف المتغيرات وتنظيف القيم والمفقودات والبنود العكسية وإعداد ملف منظم قبل الاختبارات.
ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي
يبدأ ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي قبل تشغيل أي اختبار؛ لأن البرنامج الإحصائي ما يعرف وحده إن الرقم 1 يعني ذكرًا أو موافقًا بشدة أو إجابة مفقودة. كل قيمة لازم يكون لها تعريف واضح، وكل سؤال يحتاج متغيرًا منظمًا، والبنود العكسية تحتاج معالجة صحيحة، والقيم المفقودة لازم يتم تمييزها عن الإجابات الحقيقية. الخطأ في هذي المرحلة ممكن ينتقل إلى المتوسطات والجداول والاختبارات ويعطي الباحث نتيجة محسوبة على بيانات جرى ترميزها بصورة غير صحيحة. لذلك التجهيز الجيد يبدأ من الاستبانة الأصلية، ثم بناء قاموس للمتغيرات، وإدخال أو استيراد الاستجابات، وفحص النطاق والتكرار والمنطق، وإنشاء نسخة نظيفة قابلة للتحليل مع الاحتفاظ بالبيانات الخام بدون تعديل.
ترميز بيانات الاستبيان
ترميز بيانات الاستبيان يعني تحويل الإجابات إلى قيم أو فئات منظمة يستطيع الباحث والبرنامج الإحصائي التعامل معها بدون فقد معنى السؤال الأصلي.
لكن الترميز مو مجرد استبدال الكلمات بأرقام.
قبل إعطاء أي إجابة رقمًا لازم نعرف نوع السؤال ووظيفة الرقم.
في سؤال مثل المستوى الدراسي، يمكن استخدام أرقام لتمثيل الفئات، لكن الرقم هنا مجرد رمز للفئة وليس قيمة كمية بالضرورة.
إذا تم ترميز السنة الأولى بالرقم 1 والثانية بالرقم 2 والثالثة بالرقم 3، هذا ما يعني تلقائيًا إن الفرق بين 1 و2 يساوي إحصائيًا الفرق بين 2 و3 في كل نوع من التحليل.
وفي سؤال ثنائي مثل "نعم / لا" يمكن وضع ترميز واضح وثابت، مثل قيمة لكل إجابة، بشرط تسجيل معنى القيم في قاموس البيانات.
أما مقياس الاستجابة المتدرج فيحتاج تحديد اتجاه الدرجات.
هل الدرجة الأعلى تعني اتجاهًا أكثر إيجابية؟
هل توجد عبارات معكوسة؟
هل نفس طريقة الترميز مستخدمة في جميع المحاور؟
ومن الأخطاء الخطيرة تغيير معنى الرقم من سؤال لآخر بدون تسجيل ذلك.
إذا كانت القيمة 1 تعني "موافق بشدة" في محور وتعني "لا أوافق بشدة" في محور آخر، فقد يتم حساب الدرجات بصورة خاطئة إذا لم يكن هذا الاختلاف مقصودًا وموثقًا.
-
كل قيمة رقمية لازم يكون لها معنى مكتوب بوضوح داخل قاموس المتغيرات
-
الأرقام المستخدمة لتمثيل الفئات ما تحول المتغير الاسمي تلقائيًا إلى متغير كمي
-
اتجاه مقياس الاستجابة يتم تثبيته أو توثيق اختلافه قبل حساب درجات المحاور
تجهيز بيانات البحث للتحليل
يعني تجهيز بيانات البحث للتحليل نقل الملف من مرحلة "إجابات تم جمعها" إلى مرحلة "بيانات يمكن الاعتماد عليها في التحليل".
في البداية يفضل الاحتفاظ بنسخة خام من الملف كما خرج من نموذج جمع البيانات.
هذي النسخة ما يتم التعديل عليها مباشرة؛ لأنها تمثل الأصل اللي يقدر الباحث يرجع له لو اكتشف اختلافًا لاحقًا.
بعدها يتم إنشاء نسخة عمل للتنظيف والترميز.
داخل نسخة العمل تتم مراجعة أسماء الأعمدة والأسئلة والقيم.
إذا كان السؤال مكتوبًا كجملة طويلة جدًا، يمكن إعطاؤه اسم متغير مختصر ومنظم، لكن مع الاحتفاظ بوصف كامل يوضح السؤال الأصلي.
ثم يتم فحص نطاق القيم.
لو السؤال من خمس درجات، لازم نعرف هل الملف يحتوي أرقامًا خارج النطاق.
ويتم فحص الأسئلة اللي تخضع لشروط انتقال.
مثلًا إذا السؤال الأول يقول "هل سبق لك استخدام الخدمة؟" وأجاب المشارك "لا"، ثم ظهرت له أسئلة عن عدد مرات الاستخدام رغم إن تصميم الاستبانة كان يفترض تجاوزها، هذي الحالة تحتاج مراجعة.
كذلك يتم مراجعة القيم المفقودة.
الخانة الفارغة مو دائمًا لها نفس المعنى.
قد تكون إجابة لم يكتبها المشارك، أو سؤالًا ما كان مطلوبًا منه أصلًا بسبب مسار الاستبانة.
التمييز بين الحالتين مهم جدًا.
-
يتم الاحتفاظ بملف البيانات الخام كنسخة أصلية منفصلة عن ملف التنظيف والتحليل
-
كل تعديل على البيانات يفضل أن يكون قابلًا للتتبع بدل تغيير القيم بدون تسجيل السبب
-
القيم الفارغة الناتجة عن تخطي سؤال منطقي قد تختلف عن البيانات المفقودة بسبب عدم الإجابة
إدخال بيانات الاستبانة
تحتاج إدخال بيانات الاستبانة إلى نظام ثابت خصوصًا إذا كانت الإجابات مأخوذة من نماذج ورقية أو مصادر متعددة.
في أغلب الاستبيانات يكون من العملي أن يمثل كل صف حالة أو مشاركًا واحدًا، بينما يمثل كل عمود متغيرًا أو بندًا، لكن بنية الملف النهائية تتحدد حسب طبيعة البحث ونوع البيانات.
قبل الإدخال اليدوي يتم إنشاء قالب واضح.
يحتوي القالب على أسماء المتغيرات مرتبة بنفس تسلسل الاستبانة أو بتسلسل مدروس يسهل المراجعة.
بعدها يتم إدخال القيم فقط حسب نظام الترميز المتفق عليه.
إذا كانت الاستجابات قادمة من نموذج إلكتروني، فهذا يقلل جزءًا من الإدخال اليدوي لكنه ما يلغي المراجعة.
قد يحتوي الملف المُصدّر على تاريخ ووقت وعناوين أسئلة طويلة وحقول تقنية وأسئلة نصية تحتاج تجهيزًا قبل التحليل.
ويجب الانتباه إلى عدم تعديل الإجابة الأصلية لمجرد إنها تبدو غريبة.
لو المشارك اختار إجابة غير متوقعة لكنها ضمن الخيارات المتاحة، فهي تظل استجابة حقيقية ما لم يوجد سبب منهجي موثق لاستبعادها.
أما أخطاء الإدخال الواضحة، مثل كتابة قيمة 55 بدل 5، فتحتاج الرجوع للمصدر الأصلي قبل التصحيح كلما كان ذلك ممكنًا.
وفي الإدخال اليدوي للملفات الكبيرة يمكن تنفيذ مراجعة عينة من الصفوف أو المطابقة مع النماذج الأصلية لاكتشاف نمط الأخطاء.
-
قالب الإدخال يتم تحديده قبل بدء التفريغ حتى ما تتغير طريقة التسجيل أثناء العمل
-
البيانات المستوردة إلكترونيًا تحتاج مراجعة مثل البيانات المدخلة يدويًا حتى لو ما كان هناك إدخال يدوي مباشر
-
القيمة غير المتوقعة ما يتم تغييرها لأنها غير مريحة للباحث إذا كانت إجابة حقيقية ومسموحًا بها في الأداة
تعريف متغيرات الدراسة
يُعتبر تعريف متغيرات الدراسة حلقة الربط بين الاستبانة وخطة البحث وملف البيانات.
اسم العمود وحده ما يكفي.
لازم يعرف الباحث وش يمثل هذا المتغير وكيف تم قياسه وش القيم الممكنة فيه.
يمكن مثلًا أن يتضمن تعريف المتغير:
-
اسم المتغير داخل ملف البيانات
-
نص السؤال أو البند الأصلي
-
وصف مختصر للمتغير
-
نوع الإجابة
-
قيم الترميز ومعناها
-
القيمة المفقودة إذا تم تحديد رمز لها
-
هل البند عكسي؟
-
المحور اللي ينتمي له
-
طريقة احتساب الدرجة إذا كان جزءًا من مقياس
هذا التعريف يشكل ما يمكن تسميته قاموس البيانات أو دليل المتغيرات.
وجوده مهم جدًا لما تكون الاستبانة طويلة.
بعد شهرين من جمع البيانات ممكن الباحث ينسى هل Q17 كان تابعًا لمحور الرضا أو سهولة الاستخدام، أو هل القيمة 1 كانت أعلى درجة أو أقل درجة.
القاموس يمنع الاعتماد على الذاكرة.
كما يساعد عند مشاركة الملف مع محلل آخر؛ لأن الشخص ما يحتاج يخمن معنى الأعمدة.
ويجب أن يظل تعريف المتغير متوافقًا مع الرسالة نفسها.
إذا تغير اسم المحور أثناء كتابة المنهج، لازم يتم التأكد إن اسم المتغيرات والملفات والتحليل يعكس النسخة النهائية.
-
قاموس البيانات يحفظ معنى كل متغير ونظام ترميزه بدل الاعتماد على أسماء مختصرة غير مفهومة
-
تعريف المتغير يربطه بالسؤال والمحور وطريقة القياس وليس بالعمود داخل الملف فقط
-
أي تغيير في المحاور أو الأداة يحتاج تحديثًا متزامنًا لقاموس البيانات حتى ما توجد نسختان مختلفتان من المعنى
ترميز إجابات المشاركين
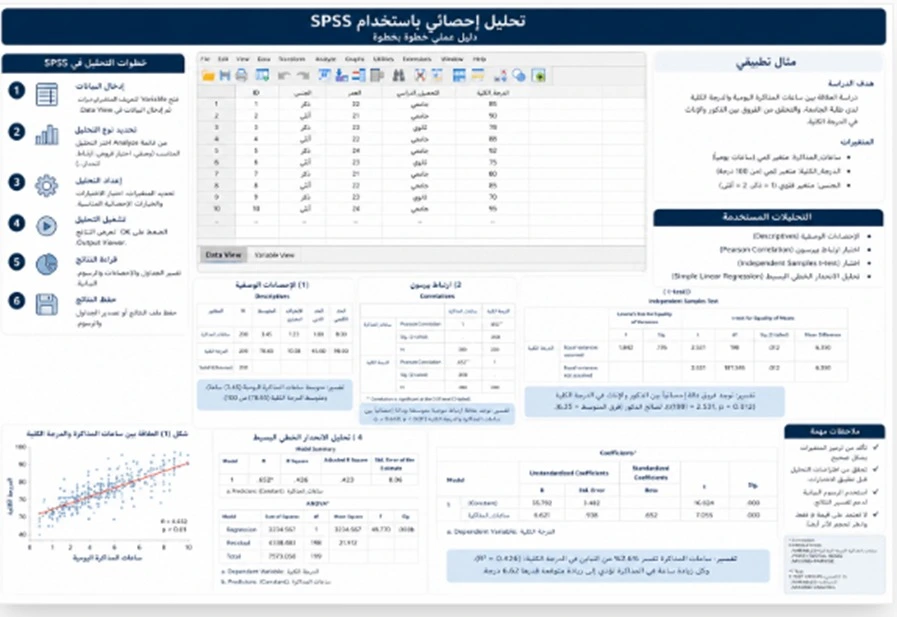
تحتاج ترميز إجابات المشاركين إلى قواعد مختلفة حسب نوع السؤال.
في الأسئلة الثنائية يكون الترميز عادة بسيطًا.
وفي الأسئلة متعددة الفئات يتم تعيين رمز مستقل لكل فئة.
لكن الأسئلة اللي تسمح للمشارك باختيار أكثر من إجابة تحتاج تعاملًا مختلفًا.
إذا كان السؤال يقول "اختر جميع المصادر التي تستخدمها"، ما ينفع دائمًا وضع كل التركيبات الممكنة في متغير واحد.
في كثير من التصاميم يكون أوضح إنشاء متغير منفصل لكل خيار يوضح هل تم اختياره أو لا، بحسب خطة التحليل وطبيعة السؤال.
أما الإجابات المفتوحة فلا ينبغي تحويلها إلى أرقام بصورة عشوائية.
لو الهدف تحليل مضمون الإجابات، نحتاج أولًا بناء فئات ترميز واضحة وتحديد قواعد تصنيف النصوص.
وقد تظل الإجابة النصية الأصلية محفوظة إلى جانب الفئة المرمزة حتى يمكن الرجوع إليها.
كذلك الأسئلة من نوع "أخرى، اذكر" تحتاج الاحتفاظ بالنص الأصلي ومراجعة هل بعض الإجابات يمكن دمجها مع فئة موجودة أصلًا أو تحتاج فئة مستقلة.
ولا يصح إنشاء فئة جديدة بعد رؤية النتيجة فقط لأنها تساعد على الحصول على توزيع معين.
قواعد التصنيف لازم تكون منطقية وثابتة قدر الإمكان.
-
السؤال متعدد الاختيارات قد يحتاج أكثر من متغير حتى يتم تمثيل كل اختيار بصورة قابلة للتحليل
-
الإجابات المفتوحة تحتاج إطار ترميز واضح إذا كان سيتم تحويلها إلى فئات رقمية
-
النص الأصلي يفضل الاحتفاظ به عند ترميز الأسئلة المفتوحة حتى يمكن مراجعة دقة التصنيف لاحقًا
تجهيز ملف البيانات الإحصائي
يعتمد تجهيز ملف البيانات الإحصائي على إنشاء ملف مفهوم حتى لو فتحه الباحث بعد فترة طويلة أو استخدمه محلل آخر.
الأسماء العشوائية مثل "س1" و"س2" فقط قد تكون كافية في ملف صغير جدًا، لكنها تصبح مربكة في استبانة تحتوي عشرات البنود والمحاور.
الأفضل وجود نظام تسمية واضح.
مثلًا يمكن أن تعكس أسماء المتغيرات المحور ورقم البند بطريقة مختصرة، مع الاحتفاظ بالنص الكامل في قاموس البيانات.
ويتم ترتيب الأعمدة بصورة تسهل الفهم.
قد تبدأ بمعرف الحالة ثم المتغيرات الأساسية ثم البنود مرتبة حسب المحاور.
لكن ما فيه ترتيب إلزامي واحد لكل البحوث.
المهم هو الوضوح والثبات.
كما يجب تمييز المتغيرات الأصلية عن المتغيرات المحسوبة.
إذا تم إنشاء درجة كلية لمحور من عدة بنود، يكون لها اسم مختلف بوضوح عن البنود الأصلية.
وكذلك إذا تم تحويل العمر من عدد سنوات إلى فئات، الأفضل الاحتفاظ بمتغير العمر الأصلي بجانب المتغير الجديد ما لم توجد حاجة منهجية مختلفة.
هذا يمنع فقد البيانات الخام.
ومن المهم كذلك ضبط نوع البيانات داخل البرنامج.
بعض المتغيرات تكون رقمية، وبعضها نصيًا، والتاريخ له شكل مختلف.
الإدخال غير الصحيح للنوع قد يسبب مشكلات عند الفرز والحساب والتحليل.
-
أسماء المتغيرات يتم تنظيمها بطريقة تساعد على فهم الملف بدل الاعتماد على تسميات مبهمة
-
المتغيرات المحسوبة أو المعاد ترميزها يتم فصلها عن البيانات الأصلية حتى يمكن الرجوع للقيمة الأولى
-
نوع كل متغير داخل البرنامج يتم ضبطه وفق طبيعة البيانات وليس بناءً على شكل الرقم الظاهر فقط
تحويل الاستبيان إلى بيانات رقمية
لا يعني تحويل الاستبيان إلى بيانات رقمية إن كل سؤال لازم يصبح رقمًا بأي طريقة.
الهدف هو إنشاء تمثيل مناسب للإجابة يحافظ على معناها ويخدم التحليل.
في مقياس متدرج، يمكن استخدام قيم رقمية لتمثيل درجات الاستجابة إذا كان هذا جزءًا من تصميم الأداة.
أما المتغيرات الاسمية، مثل المنطقة أو التخصص، فقد تُعطى رموزًا رقمية فقط لتسهيل التخزين والتحليل.
لكن الرقم هنا يظل "اسمًا مشفرًا" للفئة.
ما ينفع حساب متوسط الأرقام الممثلة للتخصصات ثم تفسيره كأنه متوسط كمي له معنى.
وكذلك رقم الهوية الداخلية للمشارك مو متغيرًا تحليليًا في حد ذاته؛ هو معرف يساعد على تمييز الصفوف.
وفي الأسئلة التي تجمع عدد مرات أو عمرًا أو درجة فعلية، القيمة الرقمية تحمل معنى كميًا مختلفًا.
لهذا لازم يعرف الباحث مستوى القياس بدل النظر إلى كل عمود رقمي على إنه من النوع نفسه.
كما يتم الانتباه للتواريخ.
تاريخ الميلاد مثلًا يمكن استخدامه لحساب العمر عند الحاجة، لكن الاحتفاظ بتاريخ كامل قد يكون أكثر تحديدًا للهوية من المطلوب.
إذا البحث يحتاج العمر فقط، تُراجع الحاجة إلى الاحتفاظ ببيانات شخصية أكثر تفصيلًا ضمن متطلبات الدراسة والخصوصية.
-
تحويل الكلمات إلى أرقام لأغراض الترميز ما يغير طبيعة القياس الأصلية للمتغير
-
معرف المشارك يُستخدم لتنظيم الحالات ولا يتم التعامل معه كمتغير كمي لمجرد إنه مكتوب بالأرقام
-
البيانات الشخصية يتم الاحتفاظ منها بما يخدم البحث فعلًا وفق متطلبات الدراسة والخصوصية
مراجعة ترميز المتغيرات
تتم مراجعة ترميز المتغيرات قبل التحليل النهائي للتأكد إن المعنى المكتوب في قاموس البيانات هو نفسه الموجود فعليًا داخل الملف.
أول اختبار بسيط هو استخراج تكرارات للقيم.
إذا كان متغير يفترض يحتوي القيم من 1 إلى 5 وظهر الرقم 7، فهذه إشارة تحتاج فحصًا.
ولو متغير الجنس أو التخصص يحتوي قيمة ما لها تعريف في قاموس الترميز، لازم نعرف مصدرها.
بعدها تتم مراجعة البنود العكسية.
البند العكسي مو بند "سلبي" فقط من الناحية اللغوية؛ هو بند تحتاج درجته إلى التعامل وفق طريقة حساب المقياس المعتمدة.
ويجب تنفيذ إعادة الترميز في متغير جديد أو بطريقة موثقة تتيح الرجوع للدرجة الأصلية.
كذلك يتم فحص عدم خلط رموز البيانات المفقودة مع إجابات حقيقية.
لو تم استخدام 99 للدلالة على المفقود، لازم نتأكد إن 99 ليست قيمة ممكنة فعلًا في المتغير.
وفي البرامج الإحصائية يمكن تعريف القيم المفقودة أو التعامل معها بالطريقة التي تناسب خطة التحليل بدل تركها كرقم عادي يدخل في الحساب.
كما تتم مراجعة الاتساق بين المتغيرات.
إذا المشارك أجاب إنه ما استخدم خدمة معينة لكن لديه عشر إجابات تفصيلية عن تجربته معها، ممكن تكون المشكلة في مسار الاستبانة أو في طريقة الإدخال وتحتاج فحصًا.
-
التكرارات والمدى من أبسط الأدوات لاكتشاف رموز غير متوقعة قبل بدء الاختبارات
-
إعادة ترميز البنود العكسية تُوثق مع الاحتفاظ بإمكانية الرجوع للقيم الأصلية
-
الفحص المنطقي بين المتغيرات يكشف مشكلات ما تظهر من فحص كل عمود بصورة منفصلة
إعداد قاعدة بيانات البحث
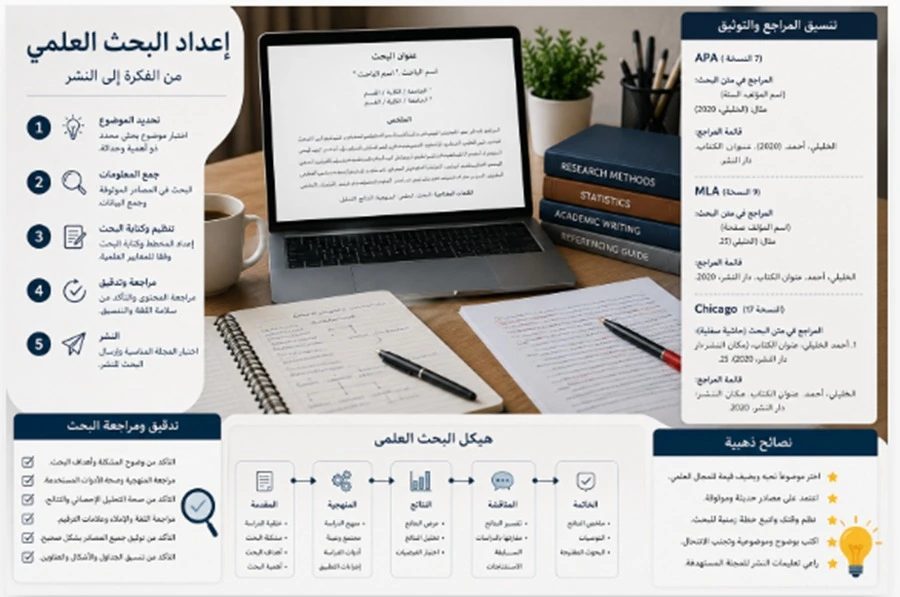
يحتاج إعداد قاعدة بيانات البحث إلى التفكير في التنظيم والدقة والحماية معًا.
أولًا يفضل فصل معلومات التعريف المباشر، إذا كانت موجودة وضرورية أصلًا، عن ملف التحليل متى كان تصميم البحث يسمح بذلك.
ملف التحليل في كثير من الدراسات ما يحتاج اسم المشارك أو رقم هاتفه.
يمكن استخدام معرف داخلي للربط إذا كانت هناك حاجة منهجية مشروعة.
ثانيًا يتم الاحتفاظ بمستويات مختلفة من الملفات.
نسخة خام.
نسخة منظفة.
وقد توجد نسخة تحليلية تحتوي المتغيرات المحسوبة.
التسمية الواضحة للإصدارات تمنع إن الباحث يحلل الملف الخطأ.
ومن الأفضل عدم وجود ملفات بأسماء مثل "final"، ثم "final2"، ثم "final-last" بدون معرفة أي واحد منها هو المعتمد.
يمكن استخدام تاريخ أو رقم إصدار واضح.
ثالثًا يتم الاحتفاظ بقاموس البيانات وملاحظات التنظيف مع الملف.
إذا تم استبعاد حالة، يُسجل السبب.
إذا تم دمج فئتين، يُذكر القرار.
إذا تم إنشاء متغير جديد، يتم توثيق طريقة حسابه.
هذا يجعل خطوات تجهيز البيانات قابلة للمراجعة.
كما يساعد الباحث لاحقًا لما يكتب فصل المنهج؛ لأنه يعرف بالضبط وش تم عمله بدل محاولة تذكر الإجراءات بعد شهور.
-
قاعدة البيانات الجيدة تشمل الملف نفسه وقاموس المتغيرات وسجل التعديلات المهمة
-
فصل النسخة الخام عن النسخة المنظفة يقلل خطر فقد الأصل أو تعديل الاستجابات بدون إمكانية الرجوع لها
-
أسماء الإصدارات الواضحة تمنع إجراء التحليل على ملف قديم أو غير مكتمل
تجهيز البيانات قبل الاختبارات
تمثل تجهيز البيانات قبل الاختبارات آخر نقطة فاصلة قبل بدء التحليل الوصفي والاستدلالي.
في هذي المرحلة يتم التأكد إن الملف جاهز فعلًا للإجابة عن أسئلة الدراسة.
يتم فحص عدد الحالات النهائي.
إذا تم جمع 350 استجابة لكن التحليل سيستخدم 327، لازم يكون واضحًا وش صار للحالات الأخرى.
هل كانت مكررة؟
ناقصة بصورة كبيرة؟
غير مؤهلة حسب شروط العينة؟
ما يتم حذف الحالات فقط للوصول لنتيجة مختلفة.
بعدها تتم مراجعة القيم المفقودة وطريقة التعامل معها.
ثم البنود العكسية ودرجات المحاور.
إذا المحور يتكون من ستة بنود، يتم التأكد إن البنود الستة الصحيحة هي اللي دخلت في الحساب وبالاتجاه الصحيح.
كذلك يمكن فحص التوزيعات والوصف الأولي للكشف عن قيم غير متوقعة قبل الاختبارات.
لكن مرحلة التنظيف ما تعني تعديل البيانات لتصبح "مثالية".
القيمة المتطرفة يمكن تكون حالة حقيقية.
قبل حذفها أو تعديلها لازم يتم معرفة سببها وتأثيرها والمنهج المناسب للتعامل معها.
وفي النهاية تتم مطابقة الملف مرة أخيرة مع أسئلة البحث.
هل جميع المتغيرات اللازمة موجودة؟
هل أسماء المجموعات مفهومة؟
هل طريقة حساب كل درجة موثقة؟
إذا الإجابة نعم، ينتقل الملف إلى مرحلة التحليل بدل محاولة إصلاح الترميز أثناء استخراج النتائج.
-
العدد النهائي للحالات يحتاج تفسيرًا واضحًا إذا كان مختلفًا عن عدد الاستجابات التي تم جمعها
-
تجهيز البيانات ما يعني حذف كل قيمة غير معتادة حتى تصبح النتائج أجمل أو أكثر دلالة
-
قبل الاختبارات يتم التأكد إن كل متغير يحتاجه سؤال بحثي موجود ومُرمز ومحسوب بالطريقة الصحيحة
وش الفرق بين البيانات الخام والبيانات المنظفة وملف التحليل؟
الخلط بين هذي الملفات من أكثر الأشياء اللي تسبب ارتباكًا في المشاريع البحثية.
وجود الثلاثة مو تعقيد زائد.
هو وسيلة لحماية البحث.
لو ظهر بعد شهر إن بندًا تم عكسه بصورة خاطئة، يقدر الباحث يرجع للأصل ويعيد الخطوة بدل فقدان الإجابات الحقيقية.
وش لازم يحتوي قاموس البيانات؟
قاموس البيانات ما يحتاج يكون معقدًا، لكنه لازم يزيل الغموض.
من المفيد أن يحتوي على:
وجود قاموس واضح يوفر وقتًا كبيرًا في التحليل والمراجعة ويقلل خطر تفسير العمود بصورة خاطئة.
كيف نتعامل مع البنود العكسية؟
البند العكسي يحتاج مراجعة حسب طريقة بناء الأداة الأصلية.
لو الدرجة الأعلى في بقية البنود تعني مستوى أعلى من المفهوم، بينما العبارة العكسية تسير في الاتجاه المقابل، فقد تحتاج درجتها إلى إعادة ترميز قبل دمجها مع بقية المحور.
لكن ما يصح افتراض إن كل جملة تحتوي نفيًا هي بند يحتاج عكسًا.
المرجع هو طريقة تصميم المقياس وتعليماته.
وفي مقياس من خمس درجات، عملية العكس تغير اتجاه القيم وفق نظام المقياس، لكن الأفضل عدم تعديل العمود الخام نفسه.
يتم إنشاء متغير معاد الترميز أو تنفيذ الإجراء بصورة موثقة.
بعدها يتم التحقق من إن الدرجة الجديدة أصبحت في الاتجاه الصحيح قبل حساب المجموع أو المتوسط.
خطأ واحد هنا ممكن يؤثر على درجة المحور بالكامل.
كيف نتعامل مع البيانات المفقودة؟
البيانات المفقودة مو نوعًا واحدًا.
قد يترك المشارك سؤالًا بدون إجابة.
وقد يكون السؤال غير مطبق عليه بسبب شرط انتقال.
وقد تكون القيمة فقدت بسبب خطأ تقني.
لهذا أول خطوة هي معرفة سبب الفراغ بقدر الإمكان.
بعدها يتم تحديد طريقة التسجيل والتعامل وفق خطة التحليل.
ما يصح استبدال كل قيمة مفقودة تلقائيًا بالمتوسط بدون دراسة؛ لأن طريقة المعالجة تعتمد على مقدار البيانات المفقودة ونمطها ونوع المتغير والتحليل المستخدم.
وكذلك استخدام الرقم صفر للدلالة على المفقود يكون مشكلة إذا الصفر إجابة حقيقية ممكنة.
القاعدة الأساسية هي إن القيمة المفقودة لازم تكون مميزة بوضوح عن أي استجابة فعلية.
أخطاء شائعة في ترميز بيانات الاستبيان
أخطاء التجهيز أحيانًا ما تظهر إلا بعد ظهور نتيجة غريبة.
من الأخطاء المتكررة:
-
عكس معنى 1 و5 بين محورين بدون توثيق.
-
نسيان إعادة ترميز بند عكسي.
-
استخدام صفر للمفقود رغم إن الصفر إجابة ممكنة.
-
وضع السؤال متعدد الاختيارات في خلية واحدة بطريقة يصعب تحليلها.
-
حذف النص الأصلي للأسئلة المفتوحة بعد تصنيفها.
-
كتابة المتغير نفسه بأكثر من اسم.
-
تحويل العمر إلى فئات وحذف القيمة الأصلية بدون حاجة.
-
دمج فئتين بعد رؤية النتائج بدون مبرر.
-
تعديل إجابة حقيقية لأنها تبدو غير منطقية للباحث.
-
حذف حالات بدون تسجيل السبب.
-
خلط الملف الخام بالنسخة المنظفة.
-
احتساب محور من بنود غلط.
-
عدم تحديث قاموس البيانات بعد تعديل الترميز.
-
إدخال الأرقام كنصوص في بعض الصفوف وأرقام فعلية في صفوف أخرى.
-
تشغيل الاختبارات قبل إنهاء فحص القيم والنطاق.
خطأ ترميز واحد قد ينتقل إلى عشرات الجداول، لذلك إصلاحه في البداية أسهل بكثير من اكتشافه بعد كتابة النتائج.
ليش تجهيز البيانات مرحلة مستقلة عن التحليل الإحصائي؟
لأن اختيار الاختبار الصحيح ما يصلح ملفًا تم ترميزه بصورة خاطئة.
لو بند عكسي دخل بالاتجاه الخاطئ، التحليل سيستخدم القيمة اللي أمامه.
ولو رمز المفقود دخل كأنه استجابة، البرنامج ممكن يحسبه ضمن المتوسط.
ولو تم دمج فئات بصورة غير صحيحة، الاختبار راح يقارن مجموعات ما تمثل البيانات الأصلية.
لهذا نقدر نقسم العملية إلى ثلاث مراحل:
جمع البيانات → تجهيز وترميز وتنظيف البيانات → التحليل الإحصائي.
كل مرحلة تعتمد على صحة المرحلة اللي قبلها.
وهذا هو السبب إن ملف البيانات النظيف وقاموس المتغيرات يعتبران من أهم مخرجات مرحلة التجهيز.
لماذا تختار ركن لتجهيز بيانات الاستبيان؟
يمكن في ركن للترجمة والخدمات التعليمية تحديد نطاق العمل حسب حالة البيانات بدل الانتقال مباشرة إلى الاختبارات.
قد تكون الاستجابات ما زالت في ملف إلكتروني خام وتحتاج تنظيم الأعمدة.
وقد يكون عند الباحث ملف مُدخل يدويًا ويحتاج مراجعة الترميز والنطاق.
وفي حالة أخرى تكون المشكلة في البنود العكسية أو تكوين درجات المحاور أو الأسئلة متعددة الاختيارات.
وقد يحتاج الباحث تجهيز قاموس متغيرات واضح قبل تسليم الملف للتحليل.
الهدف في هذي المرحلة مو إنتاج نتيجة إحصائية معينة.
الهدف هو تجهيز قاعدة بيانات تعكس الاستجابات اللي تم جمعها بأكبر قدر ممكن من الدقة والوضوح.
ولا يصح تغيير إجابات المشاركين أو إضافة استجابات غير موجودة أو حذف حالات لمجرد التأثير على النتيجة.
الباحث يظل مسؤولًا عن صحة جمع البيانات وعن القرارات العلمية المتعلقة بالأداة والعينة.
خطوات ترميز وتجهيز بيانات الاستبيان
يمكن تنظيم العمل بصورة واضحة:
-
استلام النسخة النهائية من الاستبانة وملف الاستجابات.
-
مقارنة الملف بالأداة للتأكد إن جميع الأسئلة والمتغيرات موجودة.
-
إنشاء نسخة خام محفوظة لا يتم تعديلها.
-
إنشاء قاموس للمتغيرات يوضح الاسم والسؤال والقيم والمعنى.
-
تحديد طريقة الترميز لكل سؤال.
-
مراجعة الأسئلة متعددة الاختيارات والمفتوحة وتحديد طريقة تمثيلها.
-
فحص القيم المفقودة وتمييز أنواعها عند الحاجة.
-
تحديد البنود العكسية وفق الأداة المعتمدة.
-
فحص نطاق القيم لاكتشاف الإدخالات غير الممكنة.
-
فحص الحالات المكررة أو المشكلات المنطقية بدون حذف آلي.
-
إنشاء المتغيرات المعاد ترميزها أو الدرجات المحسوبة مع توثيق الطريقة.
-
مراجعة عدد الحالات النهائي وأسباب أي استبعاد.
-
تحديث قاموس البيانات بعد جميع التعديلات.
-
حفظ نسخة منظفة ونسخة تحليلية واضحة الاسم.
-
إجراء فحص نهائي للملف قبل بدء الاختبارات الإحصائية.
بهذي الخطوات يكون الانتقال من الاستبانة إلى التحليل قابلًا للتتبع، ويقدر الباحث يعرف كيف تحولت كل إجابة إلى القيمة الموجودة في ملفه.
أسعار ترميز وتجهيز بيانات الاستبيان
ما فيه سعر ثابت لخدمة ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي لأن حجم العمل يتغير حسب حالة البيانات والأداة.
العوامل اللي تؤثر في نطاق الخدمة تشمل:
-
عدد المشاركين.
-
عدد بنود الاستبانة.
-
هل البيانات إلكترونية أو ورقية.
-
الحاجة لإدخال يدوي.
-
عدد المحاور.
-
وجود بنود عكسية.
-
عدد الأسئلة المفتوحة.
-
الأسئلة متعددة الاختيارات.
-
مقدار القيم المفقودة.
-
الحاجة لبناء قاموس متغيرات من البداية.
-
وجود أخطاء في ملف الإدخال.
-
الحاجة لإنشاء درجات المحاور.
-
وجود أكثر من نسخة من الاستبانة.
-
مقدار المراجعة المطلوبة قبل التحليل.
-
موعد التسليم.
ملف صادر من نموذج إلكتروني ومنظم بصورة جيدة يختلف عن مئات الاستبانات الورقية اللي تحتاج إدخالًا ومراجعة.
وكذلك أداة تحتوي أسئلة مغلقة بسيطة تختلف عن مقياس متعدد المحاور فيه بنود عكسية وأسئلة مفتوحة ومتغيرات مشتقة.
لذلك الأفضل إرسال نسخة الاستبانة وملف الاستجابات الحالي وتعريف المحاور وطريقة احتساب الدرجات إن كانت موجودة حتى يتم تحديد نطاق العمل قبل التسعير.
الأسئلة الشائعة
هل ترميز البيانات هو نفسه التحليل الإحصائي؟
لا. الترميز والتجهيز يسبقان التحليل. في هذه المرحلة يتم تنظيم الإجابات وتعريف المتغيرات وتنظيف الملف والتأكد من جاهزيته، وبعدها تبدأ الاختبارات والجداول الإحصائية.
هل لازم أحول كل إجابات الاستبيان إلى أرقام؟
لا. طريقة التمثيل تعتمد على نوع السؤال والتحليل المطلوب. بعض النصوص المفتوحة قد تظل نصية، وبعض الفئات تستخدم لها أرقام كرموز فقط بدون أن تصبح متغيرات كمية.
هل أقدر أغير قيمة غريبة داخل ملف البيانات؟
ما يتم تغيير استجابة حقيقية فقط لأنها تبدو غير متوقعة. إذا كانت القيمة خطأ إدخال واضحًا، الأفضل الرجوع للمصدر الأصلي وتوثيق التصحيح.
وش أسوي بالقيم المفقودة؟
يتم أولًا تحديد سببها ونوعها وحجمها، ثم اختيار طريقة التعامل المناسبة وفق الدراسة والتحليل. ما فيه طريقة واحدة صحيحة لكل الملفات.
وش أرسل عند طلب تجهيز البيانات؟
أرسل النسخة النهائية من الاستبانة وملف الاستجابات وتعريف المحاور وطريقة الترميز الحالية إن وجدت وأي تعليمات خاصة بالأداة أو ملاحظات من المشرف.
الخاتمة
نجاح ترميز بيانات الاستبيان وتجهيزها للتحليل الإحصائي ما يُقاس بسرعة تحويل الإجابات إلى أرقام.
القيمة الحقيقية تظهر لما يكون كل رقم داخل الملف له معنى معروف ومصدر واضح وطريقة ترميز موثقة.
الاستبانة تتحول إلى متغيرات.
والمتغيرات تحصل على أسماء وتعريفات.
والإجابات تتحول إلى قيم مناسبة بدون فقد معناها.
والبنود العكسية تُراجع.
والقيمة المفقودة ما تدخل كأنها إجابة حقيقية.
والنسخة الخام تظل محفوظة.
والنسخة المنظفة تكون قابلة للمراجعة.
وقبل تشغيل أول اختبار، يعرف الباحث بالضبط وش يمثل كل عمود وكل قيمة داخل قاعدة البيانات.
هذي المرحلة هي الجسر بين جمع الاستجابات والتحليل الإحصائي، وأي خطأ فيها ممكن ينتقل إلى النتائج مهما كان الاختبار المستخدم صحيحًا.
إذا عندك استبيان تم جمع إجاباته لكن ملف البيانات ما زال يحتاج إدخالًا أو ترميزًا أو تنظيفًا أو بناء قاموس متغيرات جهّز النسخة النهائية من الأداة وملف الاستجابات الحالي وطريقة حساب المحاور إن كانت موجودة، ثم تواصل مع ركن للترجمة والخدمات التعليمية لتحديد هل المطلوب إدخال البيانات أو مراجعة الترميز أو تجهيز ملف نظيف أو إعداد قاعدة بيانات جاهزة للانتقال إلى مرحلة التحليل الإحصائي.
هل تحتاج إلى مساعدة؟
تواصل معنا مباشرة عبر واتساب وسنرد عليك بأسرع وقت.
مقالات أخرى
اختبار فرضيات البحث واختيار الاختبار الإحصائي المناسب
اختبار فرضيات البحث واختيار الاختبار الإحصائي المناسب حسب نوع المتغيرات وتصميم الدراسة مع تفسير الدلالة وحجم الأثر ونتائج الفرضيات بدقة.
اقرأ المقال ← معالجة البياناتاختبار الثبات بمعامل كرونباخ ألفا وتفسير النتيجة
اختبار الثبات بمعامل كرونباخ ألفا مع حساب الاتساق الداخلي وتفسير القيمة ومراجعة البنود والمحاور وتحديد حدود النتيجة قبل استخدامها في البحث.
اقرأ المقال ← تحليل المشاريع البحثيةتحليل الاستبيان إحصائيا مع تفسير النتائج للباحث
حليل الاستبيان إحصائيًا مع تنظيف البيانات واختيار الاختبارات واستخراج الجداول وتفسير النتائج وربطها بأسئلة البحث بصورة واضحة للباحث.
اقرأ المقال ←